Next: B. 適合度検定 Up: A. XMLとCSVのアクセス時間の比較 Previous: A. XMLとCSVのアクセス時間の比較
 及び
 のアクセス時間を比較するような場合,それぞれのアクセス時間のデータを充分に集めことが必要である.データを充分に集めた後,それをヒストグラムに出力し,ヒストグラムのピークを正規分布でフィッティングした時,フィッティングした正規分布の関数と,ヒストグラムとの
 自由度A.1が1に近ければよいことが知られている[12][11][13].
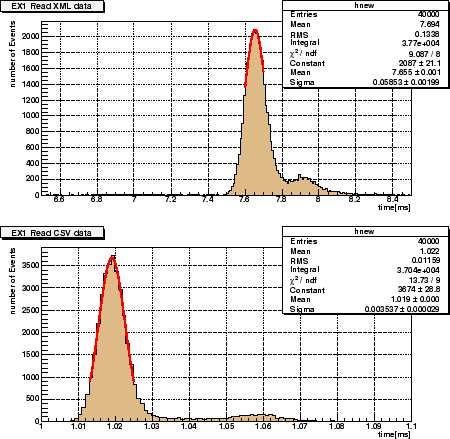
そこで,レコード数が2であるデータに対してアクセスに要した時間をそれぞれ40,000回行った.結果を図 に示す.
結果,
でアクセスした場合の平均時間は,約7.7[ms],それに対して
でアクセスした場合の時間は約1.0[ms]であった.
今回の実験データは,データのレコード数が2であったため,実行時間そのもので考えると,無視できる差である.しかし,このアクセス時間はデータ量に依存されるので,レコード数が増えれば増えるほど両者の比は無視できなくなる.
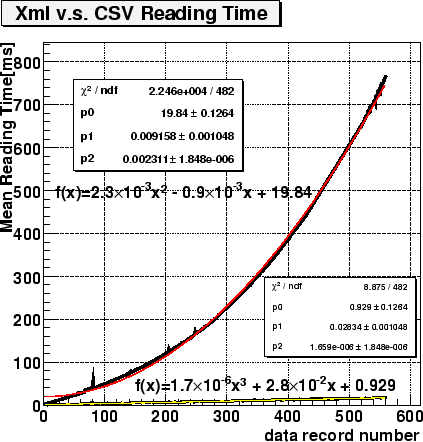
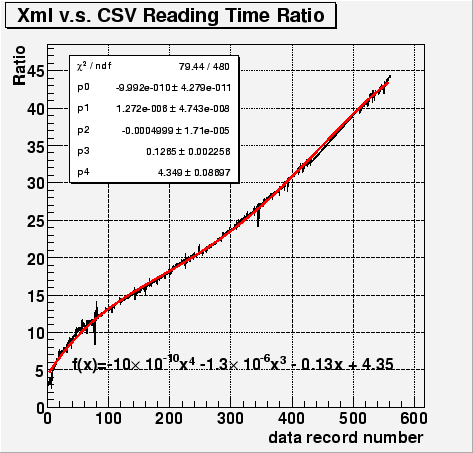
そこで,データの中のレコード数ごとのアクセス時間の比較を行った.各レコードごとに,レコードの最大数に応じて擬似乱数によって取得するデータを決定し,要素を得られるまでのアクセス時間及び,
及び
によるアクセス比率を計測した.結果を,図,図に示す.なお,図中に示される は,各プロットを3次関数でフィッティングした結果である.また,本システムはWebで公開している計算機で計測を行ったため,x軸400-500の間に信頼のできないノイズが発生したため,データを省略した.
図より,データのレコード数が増えれば増えるほどアクセスするのに要する時間は増大する傾向にあることが分かった.
また,その増加係数を知るために,3次関数でフィッティングを行った.結果,最も影響を受けやすい最も高次な項である3次の項を比較すると,
は
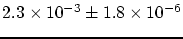 に対して,
は
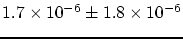 と,3オーダの差があることが分かった.
さらに,
と
のアクセス時間の比率は,常に増加傾向であることが分かった.A.2
以上より,本システムで
を利用するデータである,日々の日記データについては,要素数が大きくなりすぎないように対応する必要がある.
そこで,日記のデータは,データ量が大きくなりすぎないように,日単位でファイルを構成する.さらに,年月単位でディレクトリを構成することにより,ファイル名の重複を回避するように設計する.
すなわち,2007年1月2日のデータは,2007-01という名前でディレクトリを作成し,その中に1.xmlという名前でファイルを作成するようにする.
MURAYAMA Yoshiyuki