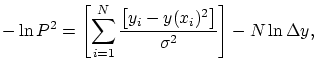Next: C. 開発者日記 Up: B. 適合度検定 Previous: B.2 確率関数
 が,理想的なモデルである
 のまわりに,それぞれランダムな正規分布に従う測定誤差を持っているとする.さらに,各々の正規分布の標準偏差
 はすべての測定点で同一とする.このときデータの組の現れる確率は各々の点の確率の積として書くことができ,
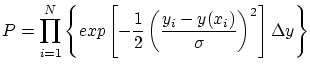 |
(B.22) |
さらに,Pに対して,その対数をとると,乗算部分は加算にできるため,負号を付けると
次に,データ点( ,
)がそれぞれ標準偏差
 を持つとすると,(
 )は,
に添字
 を付けたものに書き換えられる.よってモデルパラメータの最尤推定量は次の量を最小にすることによって得られる.
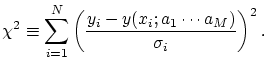 |
(B.24) |
測定誤差が正規分布に乗っていればいるほど, は,正規分布する量を一つずつ分散1に正規化して2乗もの
 個の合計に近づく.
の最小値の確率分布は解析的に導くことが可能で,自由度 の
分布は,章で示した.
こうして計算した確率は,モデルの当てはまりの良さの度合いを定量的に与える.求めた確率が小さいならば,逸脱が偶然のゆらぎである可能性は低い.このときはモデルが間違っているか,測定誤差
を捏造しているか,測定誤差が正規分布から外れているかである.
確率は,測定誤差が正規分布に従うという仮定の信頼性を直接測る量ではなく,誤差の正規性を仮定して導かれた確率である.
しかし,ほとんどの場合,誤差が正規でないと外れ値がおおくなり,確率が小さくなる.
結果として,まずまずの良さで測定誤差が,正規分布に従っているときの典型的な
の値は
 である.つまり,
 が大きくなると,統計量
は,平均値
,標準偏差
 の正規分布に漸近的に近づく.これは,図より明らかである.
MURAYAMA Yoshiyuki